Le manuscrit de Voynich est un livre illustré anonyme rédigé dans une écriture à ce jour non déchiffrée et une langue non identifiée. Sa destination et son auteur restent une énigme : s’agit-il d’un herbier, d’un traité d’alchimie, d’une œuvre ésotérique, voire simplement d’une mystification ? Cette ambiguïté a contribué à en faire l’un des documents les plus célèbres de l’histoire de la cryptographie.
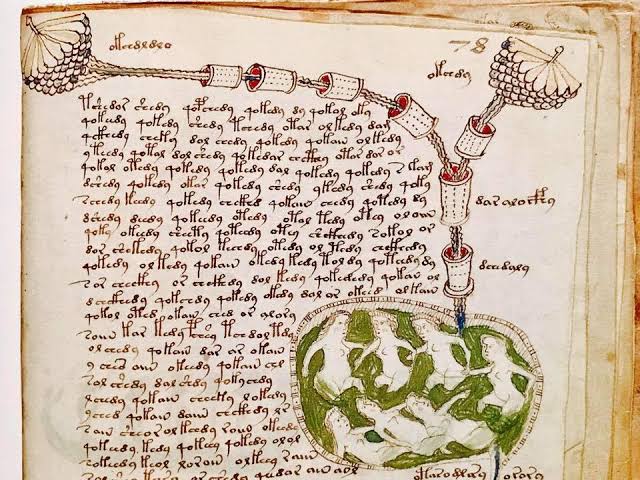
L’application de l’intelligence artificielle (IA), du traitement automatique du langage naturel (NLP) et de la linguistique computationnelle au manuscrit de Voynich (codex du XVᵉ siècle conservé à l’université Yale) a permis des avancées notables.
Bien que le texte n’ait toujours pas été traduit de façon consensuelle, l’IA a permis d’écarter certaines théories et d’en préciser la structure interne. Les principaux résultats obtenus se résument en quatre grands axes :
1. La confirmation d’un texte structuré et thématique (Topic Modeling)
L’une des théories récurrentes était que le manuscrit n’était qu’un canular composé d’un charabia aléatoire sans aucune signification. Des chercheurs de l’université de Yale (notamment la linguiste Claire Bowern et son équipe) ont appliqué des algorithmes de traitement du langage naturel (comme l’allocation de Dirichlet latente ou LDA) pour regrouper statistiquement les mots par thèmes.
- Résultat : L’IA a démontré que certains groupes de mots apparaissent spécifiquement et systématiquement dans certaines sections (herboristerie, astronomie, balnéothérapie, pharmacie) en corrélation directe avec les illustrations.
- Conclusion : Il existe une véritable cohérence sémantique liée aux images, ce qui rend l’hypothèse d’une suite de caractères générée au hasard extrêmement improbable.
2. L’identification de plusieurs scribes (Stylométrie et réseaux neuronaux)
Pendant longtemps, le débat a porté sur la paternité du manuscrit (écrit par une seule personne ou plusieurs mains).
- Des chercheurs ont combiné l’expertise de paléographes (comme Lisa Fagin Davis) avec des réseaux neuronaux et des algorithmes de classification (SVM, clustering) pour analyser les variations de tracés, de bigrammes et de trigrammes (fréquences de suites de lettres).
- Résultat : Les modèles d’apprentissage automatique ont confirmé que le document a été rédigé par au moins 4 à 5 scribes distincts. Chaque scribe possédait des habitudes orthographiques et statistiques propres, ce qui prouve qu’il s’agissait d’un projet d’atelier collaboratif et méthodique.
3. La tentative de déchiffrement algorithmique (L’expérience de l’Alberta)
En 2016-2018, une équipe de l’Université de l’Alberta (Greg Kondrak et Bradley Hauer) a fait grand bruit en utilisant un algorithme d’IA entraîné à reconnaître 380 langues :
- Hypothèse de l’IA : Le système a estimé que la langue sous-jacente la plus probable était l’hébreu ancien, crypté sous forme d’« alphagrammes » (anagrammes où les lettres d’un mot sont rangées par ordre alphabétique et les voyelles supprimées).
- Résultat et limites : Si l’algorithme a pu faire correspondre environ 80 % des mots réarrangés avec des entrées d’un dictionnaire hébreu, les phrases reconstituées ne produisaient pas de syntaxe cohérente. Cette étude a été très critiquée par la communauté des linguistes et médiévistes en raison d’un taux élevé de faux positifs inhérent à la méthode des anagrammes, mais elle a ouvert la voie à l’utilisation du déchiffrement non supervisé.
4. Propriétés statistiques : entre langue naturelle et système artificiel
L’analyse quantitative et computationnelle poussée a mis en lumière un paradoxe linguistique fascinant :
- Similitudes avec une langue humaine : Le texte respecte la loi de Zipf (la fréquence d’apparition d’un mot est inversement proportionnelle à son rang dans la table des fréquences), une signature universelle des langues naturelles.
- Anomalies structurelles : Au niveau des caractères, l’entropie conditionnelle (mesure du degré d’imprévisibilité des lettres) est anormalement basse par rapport aux langues naturelles européennes ou moyen-orientales. Les mots présentent une répétition interne et une structure de préfixes/suffixes trop rigide et prévisible.
- Piste actuelle : Les modèles génératifs et d’analyse statistique suggèrent de plus en plus un langage artificiel ou un système de chiffrement à grille/pastiche, où du vrai texte ou des concepts ont été encodés selon un protocole formel strict.
En résumé
L’intelligence artificielle n’a pas « percé » le secret du manuscrit de Voynich au sens où nous ne pouvons toujours pas le lire. En revanche, elle a transformé la recherche en établissant scientifiquement :
- Que le texte possède une cohérence thématique réelle en accord avec ses dessins ;
- Qu’il est l’œuvre de plusieurs rédacteurs coordonnés ;
- Qu’il présente des règles structurelles trop régulières pour une langue naturelle brute, orientant la recherche vers un langage codé ou artificiel.
Jean-Yves Gauchet, avec l’IA Mammouth …